DEEPO 要解决什么问题?
解决强化学习改善多模态大模型幻觉效果不稳定的问题,其根源在 rollout 层面高语义熵查询易出现全错样本组,以及优化层面对高置信错误 token 梯度更新过弱。
(翻译)DEEPO:面向多模态大语言模型幻觉的双熵增强策略优化
arXiv:2609.28570v1 Announce Type: new Abstract: Reinforcement learning (RL) is widely used to sharpen reasoning in multimodal large language models (MLLMs), yet its effect on hallucination is uneven. We trace this to two weak points in the \emph{correction chain} from reward to parameter update. At
论文提出 DEEPO,针对多模态大模型强化学习推理中幻觉改善不稳定的问题:高语义熵查询易产生全错样本组,使组内优势归零;高置信错误 token 的梯度不可见。方法结合信号方差正则与梯度预条件,用语义熵触发专家前缀注入有依据续写,并用优势符号感知的 Renyi 预条件缓解 logit 饱和。实验显示其优于 GRPO,在 VideoMMMU 上降低幻觉并保持准确率与训练稳定性。
解决强化学习改善多模态大模型幻觉效果不稳定的问题,其根源在 rollout 层面高语义熵查询易出现全错样本组,以及优化层面对高置信错误 token 梯度更新过弱。
采用双阶段增强:信号方差正则与梯度预条件,包括语义熵触发的专家前缀注入有依据续写,以及优势符号感知的 Renyi 预条件来缓解 logit 饱和。
两个分支单独均优于 GRPO,在 VideoMMMU 上交互效果显著,其他任务上效果可叠加,最终降低幻觉并保持准确率与训练稳定性。
 Grayscale:低成本智能体AI将推高算力需求商务部电子商务司负责人解读《关于实施品质电商“五优”行动的通知》人社部:将研究出台服务业发展促就业文件,扩大服务业就业总量设计系统负责人的语义生长之约束显化:把1条”绝对不能”翻译成机器规则我国牵头制定的船舶压载水管理系统调试测试国际标准发布母婴业这样用WorkBuddy就对了中国广核、宁德时代等在陆丰成立新核电公司,注册资本1亿数据越多≠决策越好:从无人机滑翔到多机器人通信,重新审视数据与信息的关系 | IROS 2026小红书+AI+知识库,我现在无敌了人社部:截至9月底三项社会保险基金累计结余11.2万亿元
 代币化革命背后
 Modal 破解 Kubernetes 限制,在几秒内扩展 100 万个并发沙箱“太一量生”完成新一轮融资乘联分会:9月1-30日全国乘用车新能源市场零售114.1万辆,同比去年9月同期下降12%央行:10月10日7天期逆回购操作量为零阶跃 Step 5 Preview 登上 OpenRouter 全球第一,10月15日开源!广东加速推进广韶高速改扩建工作,未来将缓解京港澳高速交通压力旅行成为个人 Agent 的高频场景,「豆包工作」把几十小时攻略浓缩成 PPT
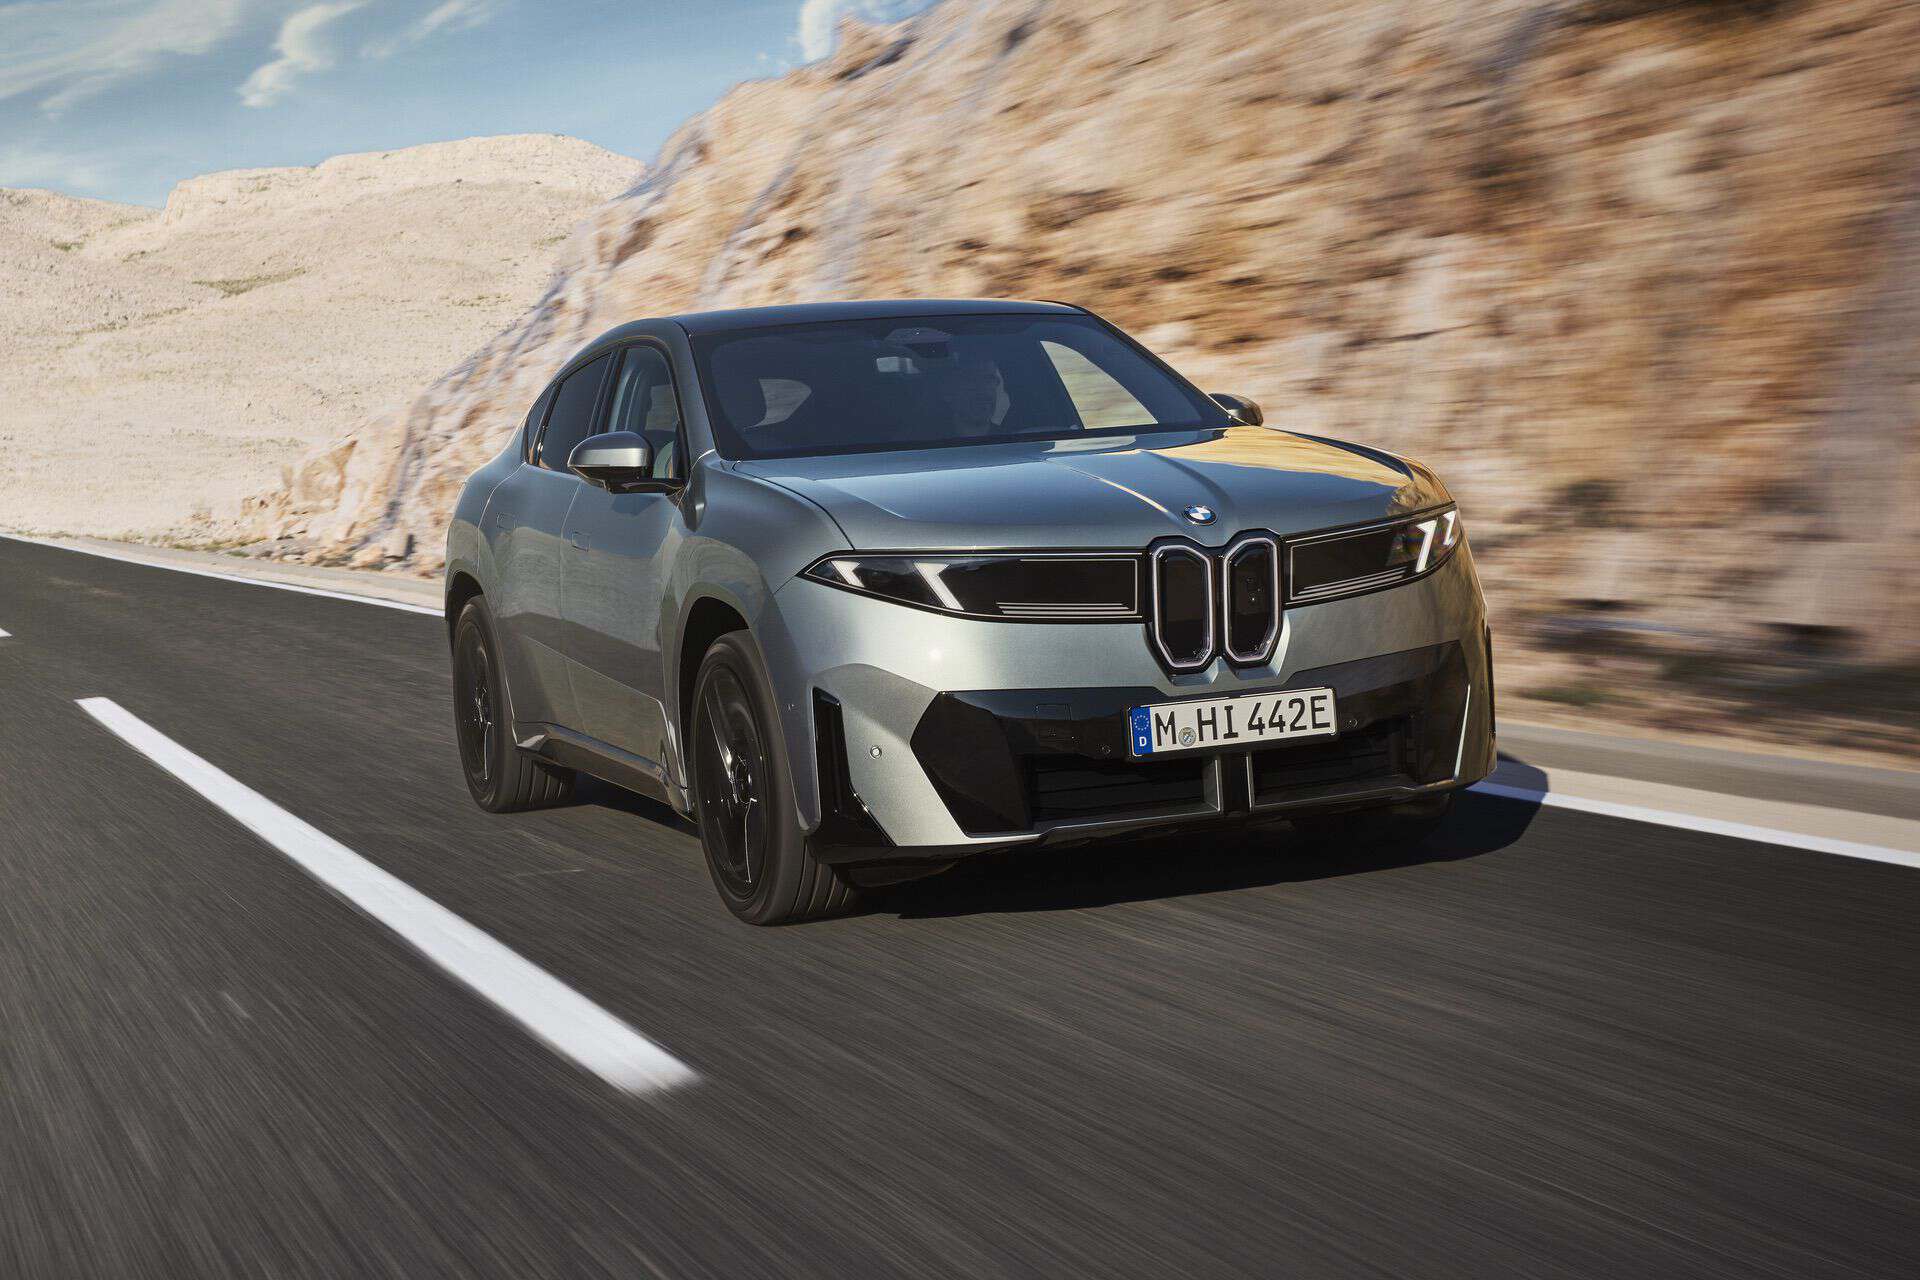 停产一年,宝马带着 iX4 重回溜背市场,海外售价 53 万元起
 OpenAI少赚200亿 倒霉却是英伟达ToolForge v0.1.8 正式发布:一口气新增 11 款实用工具,开源桌面工具箱持续进化!AI需求推动日本工业机床未交订单额超1万亿日元AI时代,注意力经济终局,意图经济登场
 重新思考 Neobank 新兴银行SpaceX:猎鹰9号火箭距执行Semp erCitiusSDA任务发射不到一小时
 不要看衰以太坊:ETH依然重要的10个理由AI产品经理到底要学哪些技术?传统PM不要把时间浪费在这3件事上富特科技:股东拟减持不超2.894%公司股份