Dense 模型和 MoE 模型在参数使用上有什么区别?
Dense 模型每个 token 都会激活全部参数;MoE 模型每层有多个专家 FFN,通过路由器为每个 token 选择 top-k 专家,仅激活部分参数,但仍需将全部参数加载到显存。
(翻译)稠密模型与 MoE 模型:激活参数、吞吐量以及何时选择各自

How can a 30B-parameter model activate only 3B parameters per token, and still use the capacity of the larger model? Nemotron 3.5…
NVIDIA 技术博客解析稠密模型与 MoE 模型的架构差异:稠密模型为每个 token 激活全部参数,MoE 通过路由器仅激活部分专家 FFN,从而将显存占用与每 token 计算量解耦。文章比较二者在吞吐、延迟、显存、并发、微调与量化上的权衡,并给出选择建议,例如 Nemotron 3.5 Lightning 以 30B 总参数仅激活 3B 参数实现高吞吐。
Dense 模型每个 token 都会激活全部参数;MoE 模型每层有多个专家 FFN,通过路由器为每个 token 选择 top-k 专家,仅激活部分参数,但仍需将全部参数加载到显存。
MoE 通常有更高的 token 吞吐,因为每个 token 只计算部分 FFN 参数;但在高并发下其延迟优势可能缩小,且实际表现受硬件、精度、推理框架和模型设计影响,需要实测。
可重点考虑显存预算、并发与延迟要求、微调计划以及量化难度。Dense 部署更简单、延迟更可预测;MoE 以固定显存换取更高吞吐和更大容量。
 黄仁勋正演讲遇特朗普突然来电:通话全程直播PS2 Fat 使用的安全芯片在时隔 26 年被破解
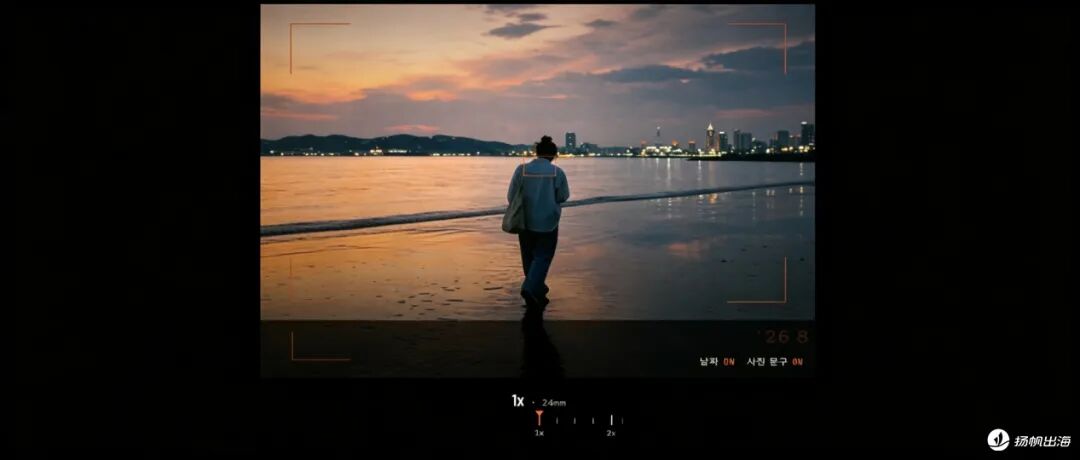 2人团队0融资,用AI搓的复古相机APP霸榜韩国总榜第4,还做到了3个月10亿销售额?
 AI不断进步 不得不把才华埋葬在昨天
 现在参与以太坊原生质押为什么要先排队一个月?
 大促GMV猛涨500%:激光雕刻设备靠"创意落地"出海东南亚
 飞书与豆包工作合体后首亮相:Agent 能进群,还能帮你写周报、做PPT
 英伟达开始限制Claude使用了
 AI 写了几十页 PPT,“经营分析”报告仍被批不够深入?英伟达带动AI数据中心大变革,中国厂商不想当边缘人Firefox 156 释出时光机器遭遇大规模机器流量
 以太坊 2026 年第二季度报告亚太唯一!腾讯云首次入选IDC MarketScape 全球托管边缘服务领导者类别
 AI不会放缓
 Agent开始调用基础设施,Kubernetes准备好了吗?量子位2026人工智能年度榜单,正式启动!
 「沃什时代」首次加息要来了?华尔街算好了三种剧本
 黄仁勋再谈AI危险论:中国会成为全球开源重要力量
 抖音上线 “免费短剧” App,短剧赛道再添一员猛将
 从接住告警到自我进化:快手智能运维助手实践|QCon上海
 渣打给ARB十美元目标价靠什么?
 Introducing Gemini 3.8 Live and 3.8 Live Extended Thinking
 号称人类造的最后一个 AI 要来了,刷屏全网的 RSI 是什么缓存不该困在一台服务器里圆桌:生长·资方投资的新方程——穿越周期的耐心与价值 | 36氪 2026产业未来大会
 早报|iOS27正式推送/比亚迪高管:燃油车在中国没有未来/iPhone 18 Pro渠道降价900元,苹果称不干预
 物理 AI 的大结果何时到来?B站AI无限竞技场今日上线!全球百大AI模型同场竞技,GPT-6高居榜首
 美股太贵 该加仓新兴市场吗?