传统VLA模型在长程操控中为什么会出错?
传统VLA模型采用静态特征融合,视觉、语言和动作历史的权重在整个执行过程中固定不变。早期出现毫米级定位偏差时,模型无法及时提高视觉权重来纠偏,误差逐步累积放大,导致后续步骤失败;子任务切换时也缺少对高层意图的动态调整,容易出现动作中断。

作者丨 张 璐 编辑丨 幸丽娟 &nbs
华东师范大学与上海交通大学团队提出S²-VLA模型,通过信念状态和自适应动态门控机制,让模型按任务阶段动态调整视觉、意图和动作注意力。仅2B参数、约7GB显存,即可在LIBERO-Long长程操控任务上达到96.4%成功率,超越多数7B以上大模型,同时大幅提升推理吞吐,为端侧机器人部署提供新思路。
传统VLA模型采用静态特征融合,视觉、语言和动作历史的权重在整个执行过程中固定不变。早期出现毫米级定位偏差时,模型无法及时提高视觉权重来纠偏,误差逐步累积放大,导致后续步骤失败;子任务切换时也缺少对高层意图的动态调整,容易出现动作中断。
S²-VLA引入轻量循环网络维持信念状态,实时感知任务进度和偏差,再由SSGAA模块将特征融合拆分为局部视觉、全局意图和动作自注意力三条通道。信念状态生成动态门控权重,根据当前阶段调整三条通道的占比:需要精确定位时提高视觉权重,子任务切换时提高意图权重,平稳移动时由动作自注意力主导。
S²-VLA仅用2B参数在LIBERO-Long上达到96.4%成功率,超过多个7B甚至8.5B模型。推理显存约7GB,吞吐量80.8Hz,远高于同类7B模型通常几Hz的水平,更适合端侧和工厂场景部署。
 Java新闻汇总:Simple JSON API、GlassFish、Jakarta EE、JNoSQL和Open Liberty、LangChain4jXspark AI 丁文伯:触觉替代不了视觉,但机器人需要一套自己的“脊髓” |物理AI 50人
 牛市的钱:是熊市里守出来的
 耐克、妮维雅、谷歌的警示:品类,正在误导品牌战略!
 号称人类造的最后一个 AI 要来了,刷屏全网的 RSI 是什么
 Anthropic CEO自爆行业黑幕
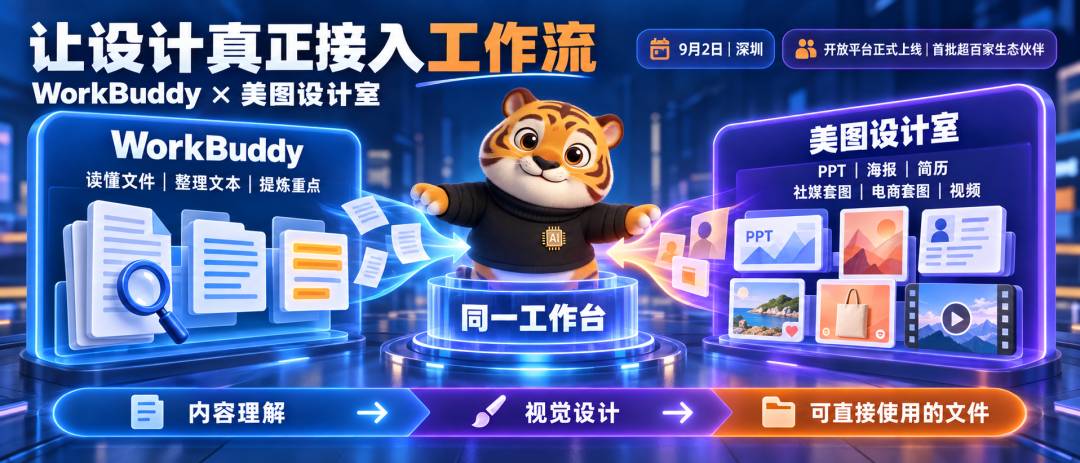 WorkBuddy + 美图设计室,在对话框里就能解决办公设计任务?
 清晰法案投票失败 后续还有机会吗?
 当黄仁勋和Dario遇上休谟:火鸡、台球与AI末日论
 苹果Siri AI上线;豆包手机助手消费版正式发布;塔克拉玛干沙漠发现两处大型地下水水源横扫四榜,DM0.5 凭什么面面俱到?基元律动与无问芯穹达成战略合作,推进高质量Token供给与应用地平线第1500万颗征程芯片搭载大众 ID. AURA T6,HSD V2.1 即将推出
 从担心AI失控 到AI造福人类:比尔盖茨怎么想高性能电动船艇动力系统公司获近亿A轮融资,海外收入增长450%丨36氪首发高通技术公司携手中兴努比亚和豆包手机助手,共同推动智能手机迈入个人AI新时代圆桌:量智共振·多元路径:共筑中国量子产业下一个十年 | 36氪 2026产业未来大会
 Grayscale:比特币能否优化私募市场投资组合?和Jeff Dean押注同一方向,27岁清华助理教授创业,两个月融资数亿圆桌:中国之光成为新共识| 36氪 2026产业未来大会数亿元!前京东副总裁“消失”4年:不造会跑的天工,他在仓库里给人形机器人“占工位”
 从”边卖边补”到”准备好再卖”:产品商品化的四步闭环
 推特创始人谈“AI减速”论:前沿不属于任何一家公司全球AI视频榜单第一梯队再添中国力量:智象发布首款物理规律导向视频模型Steam Frame 起售价 1059 美元
 高瓴系 CFO 往事:一代顶级机构年轻人的迁徙与突围
 上市前交易市场:永续合约化的Pre-IPO资产F-Droid 上的应用有多少是在 AI 帮助下编写的?
 BTC电力消耗可能已经见顶 2025年12月或为历史峰值
 从入门到精通,一篇文章带你入门产品经理!(2026 年最新版)