MoK 的 Pull 方式相比传统 Push 有什么优势?
Pull 方式让目标 GPU 主动读取所需 token,省去了多个发送方之间的目标地址协调,并能同时利用 NVLink 双向通道,在负载不均衡时最高可提升 29% 的 NVLink 利用率,signaling 延迟从约 103 微秒降到 18 微秒。

作者丨 郑佳美 编辑丨 岑 峰 &nbs
Cursor 开源 MoE 内核 MoK,将 token 调度、跨 GPU 通信与专家计算融合进单一 GPU 内核,采用 Pull 方式替代传统 Push,将 signaling 延迟从 103 微秒降至 18 微秒。在 GB300 NVL72 上,MXFP8 前向性能最高提升 2.37 倍,端到端训练吞吐提升约 41%。这标志着 AI 应用层公司开始重写底层 GPU 内核,争夺算力主权。
Pull 方式让目标 GPU 主动读取所需 token,省去了多个发送方之间的目标地址协调,并能同时利用 NVLink 双向通道,在负载不均衡时最高可提升 29% 的 NVLink 利用率,signaling 延迟从约 103 微秒降到 18 微秒。
MoK 将 GPU SM 分为通信和计算两部分,通过 minibatch 控制一次交给专家计算的 token 数,以形成至少两个完整 wave 为边界,同时使用 Ring Token Buffer 避免显存浪费,使通信和计算高效重叠。
在 GB300 NVL72 上,相比公开基线,MoK 的 MXFP8 前向最高提升 2.37 倍,反向提升 1.78 倍;端到端训练中,512 张 GPU 上单卡吞吐从每秒 760.9 个 token 提升到 1070.2 个,约提升 41%。
 CLARITY法案未通过程序性表决 OpenAI拟IPO前融资
 AI攻克世纪数学难题,顶尖数学家抱团抵制,而他们担心的并不是丢了工作
 耐克、妮维雅、谷歌的警示:品类,正在误导品牌战略!
 具透 | Liquid Glass 设计改进、性能提升……iPadOS 27 中值得一瞥的新特性
 探秘柬埔寨,千年吴哥窟36氪项目新势榜:不看包装,只看项目真实进展
 我的“一人公司”,是怎么搞钱的?
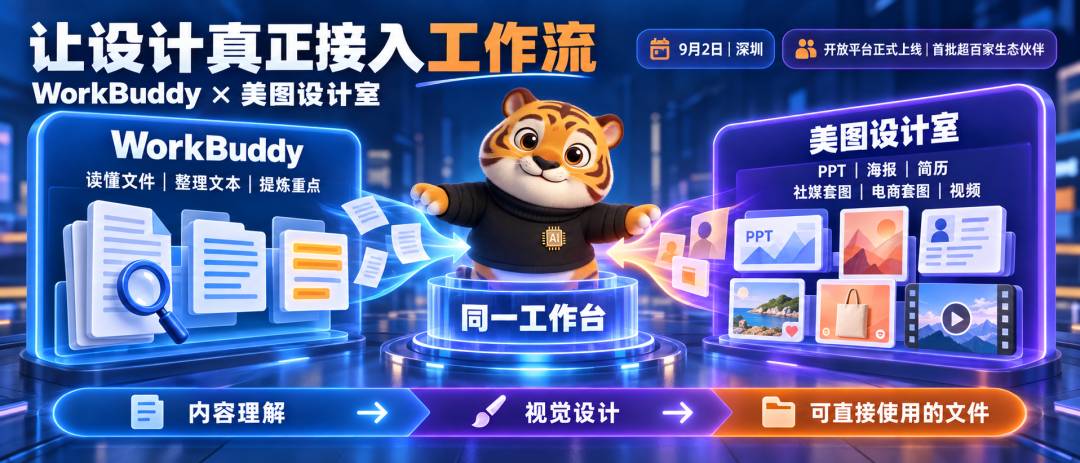 WorkBuddy + 美图设计室,在对话框里就能解决办公设计任务?
 Introducing Gemini 3.8 Live and 3.8 Live Extended Thinking
 金色Web3.0日报 | 黄仁勋批驳「AI末日论」被英伟达点名的杭州团队,补上了AI for Science的「最后一公里」字节跳动CEO梁汝波:豆包、飞书与火山引擎整合后 将加大企业市场投入
 129亿美元卖身英伟达之后,是时候重新理解Hugging Face了
 云连锁到轻连锁,品牌业务逻辑的改变
 Stella:“显化”想要的人生,60天35万美元月收入
 产品定义意义上的一级场景:四维模型
 从200亿收购失败到650亿IPO:Figma如何用“协作”颠覆设计帝国不止一颗CPU?智能体经济时代,Arm对算力平台有了新理解Denuvo 起诉黑客违反 DMCA 反规避条款
 “极端”空头压境 美联储周三不加息就是最大意外
 当我怀念旧版 Edge 浏览器时,我在怀念什么?7名博士生仅用3个月从零训练7B大模型:代码+数据+训练日志全公开
 差 11 票:币圈和华盛顿的蜜月期结束了
 贝森特回购落空与通胀重压 美联储加息或全面开启华为GTS让Agent学会「看着网络排障」,双防火墙难题几乎全拿下圆桌:探路·产业分工的新图谱,看到新未来——国家力量如何转化为产业价值 | 36氪 2026产业未来大会圆桌:智能向实,产业向新——AI如何进入真实世界 | 36氪 2026产业未来大会
 穿透查询怎样升级为穿透管控?奇安信斩获国家信息安全漏洞库CNNVD两项重磅荣誉无问芯穹联合清华、上交正式开源具身端侧推理引擎APXInf,Pi 0.5性能SOTA