OpenProblemBench 是什么?
它是一个包含82个来自数学和理论物理文献的未解决问题的基准,用于评估 AI 在基础理论科学问题上的能力。
(翻译)OpenProblemBench:在基础理论科学开放问题上对 AI 进行基准测试
Abstract page for arXiv paper 2610.11118: OpenProblemBench: Benchmarking AI on Open Problems in the Foundational Theoretical Sciences
arXiv 论文介绍 OpenProblemBench,一个包含82个数学和理论物理未解决问题的基准,用于评估 AI 在既有知识之外解决科学问题的能力。论文称 GPT-6-Astra 在七种配置中平均判定解决率最高,为14.0%。
它是一个包含82个来自数学和理论物理文献的未解决问题的基准,用于评估 AI 在基础理论科学问题上的能力。
每个问题提供研究背景、假设和既有进展,四个评估模型独立判断提交内容的正确性、完整性和进展程度。
摘要称,在七种被评估配置中,GPT-6-Astra 的平均判定解决率最高,为14.0%。
 和过往的捷豹说再见吧:Type 01 发布,用千匹动力迎接一批新买家36氪首发丨航天老兵创业做高分辨率遥感相机,连续完成多轮次近亿元融资Whose Memory Is It? Scope-Aware Commit Rules for Long-Term LLM MemoryARTEX 从 GitHub 下架
 把带权益的美股放上Solana:这条合规路径能走多远?Can AI Agents Make Open-Ended Scientific Discovery? Evidence from Station已知最早的游泳哺乳动物
 微软携英伟达发布Surface新机 推出“龙虾”个人助手Distillation for Incrimination and Distillation for Capabilities
 Building Reliable Data Analytics Agents: Lessons from the KDD Cup
 L2关停潮来袭:Blast、Abstract等明星项目为何退场
 文明级迁移风控层|长周期不可逆的文明扰动识别
 加密货币如何从根本上重塑金融体系Reading the Room: Foundations, Design, and Challenges of Normative Competence in LLMsAccelerating Floating-Point Satisfiability Solving via Gradient Normalization
 关于 AI Agent、信任与决策权的 100 条
 花旗:美联储“鸽派意外”正酝酿 核心通胀2%是关键
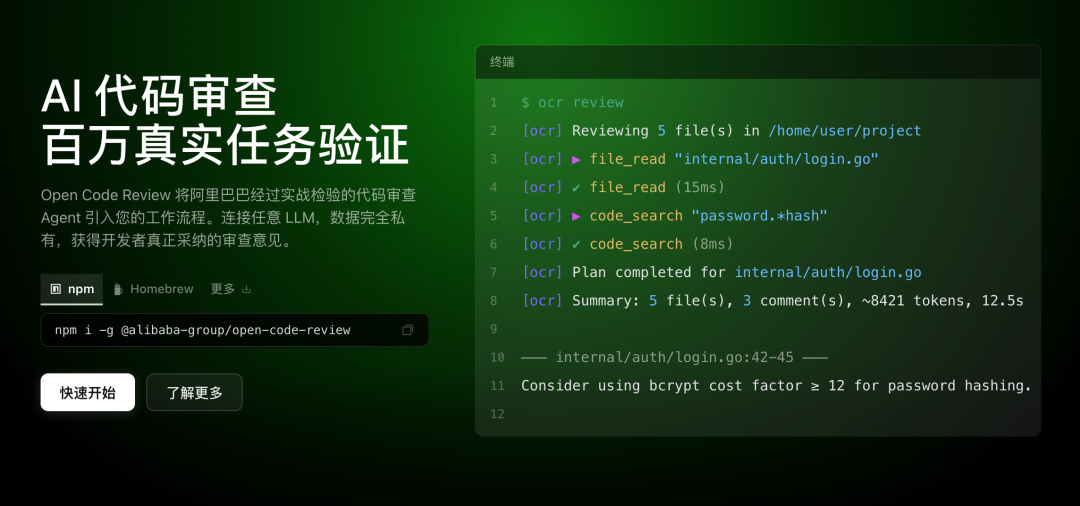 阿里开源了个神器,给WorkBuddy、豆包挑毛病
 巨资拿下低频频段 SpaceX进军手机运营商
 开源大模型推理卷上新高度,GLM-5.3 在英伟达 GB200 上飙出 100 tok/s
 投资人:AI 下一轮机会在能源 Crypto正在寻找新价值
 以太坊大区块时代将至:Glamsterdam 通过测试网首考
 医疗大模型在院内场景的落地路径与产品化难点
 企业已经有银企直联了,为什么还要再建司库?
 “AI央行”英伟达的“千亿资本局”
 Abstract 关停警示:拥有资产不等于能转出至简动力冯宗宝:在间隙仅 0.5 毫米的真实场景下,实现机器人造机器人 | IROS 2026我所知道的张磊:一场MSRA赛马与半个中国AI江湖OpenAI 针对欧洲用户在 ChatGPT 和 Codex 嵌入水印