这篇论文主要研究什么问题?
论文研究 LLM 辅助同行评审,主张从模仿人类评审转向以错误检测和验证为核心的评估。
(翻译)超越模仿:LLM 辅助同行评审的框架与基准
Abstract page for arXiv paper 2610.11087: Beyond Imitation: A Framework and Benchmark for LLM-Assisted Peer Review
该 arXiv 论文提出以验证为中心的 LLM 辅助同行评审视角,重点评估系统发现论文中逻辑矛盾等错误的能力。作者构建了通过合成插入错误形成的可扩展基准,并提出多层评审框架,以提升稿件理解、错误检测和与人类评分的一致性,同时指出系统仍易受对抗操纵影响。
论文研究 LLM 辅助同行评审,主张从模仿人类评审转向以错误检测和验证为核心的评估。
作者通过向会议论文中合成插入逻辑矛盾等错误,构建可扩展基准,以便明确评估评审系统发现错误的能力。
论文指出此类系统仍存在对抗操纵脆弱性,因此在科研同行评审等关键流程中部署时需要重视鲁棒性。
 Q3加密VC报告:种子轮遇冷 资本只认「硬通货」
 从印钱到修路:稳定币战争进入接口争夺时代Speaking the Navigator's Language: Trajectory-Grounded Instruction Translation for Frozen Aerial VLN Agents
 为交付算力 甲骨文用卡车运天然气为数据中心供电
 扔掉的是杂念,掌控的是生活:我的断舍离实践经验
 Grok Bot 玩法 01:生成 AI 早报视频的提示词36氪首发|「闹翻天PLAYFULLY」获青山资本投资,为世界造一张“中国球星卡”
 走心,你能做的最好的差异化战略Google 多个国家顶级域名被劫持
 我在山姆“进厂式”工作:外企滤镜、流水线与人间剧场
 针对 Fomo 用户的恶意书签钓鱼攻击分析Curating Always-Loaded Context for LLM Agents: A Capacitated Assortment Model with Censored Feedback
 谷歌借助 AI 与差分模糊测试将 C 语言依赖库改写为 Rust
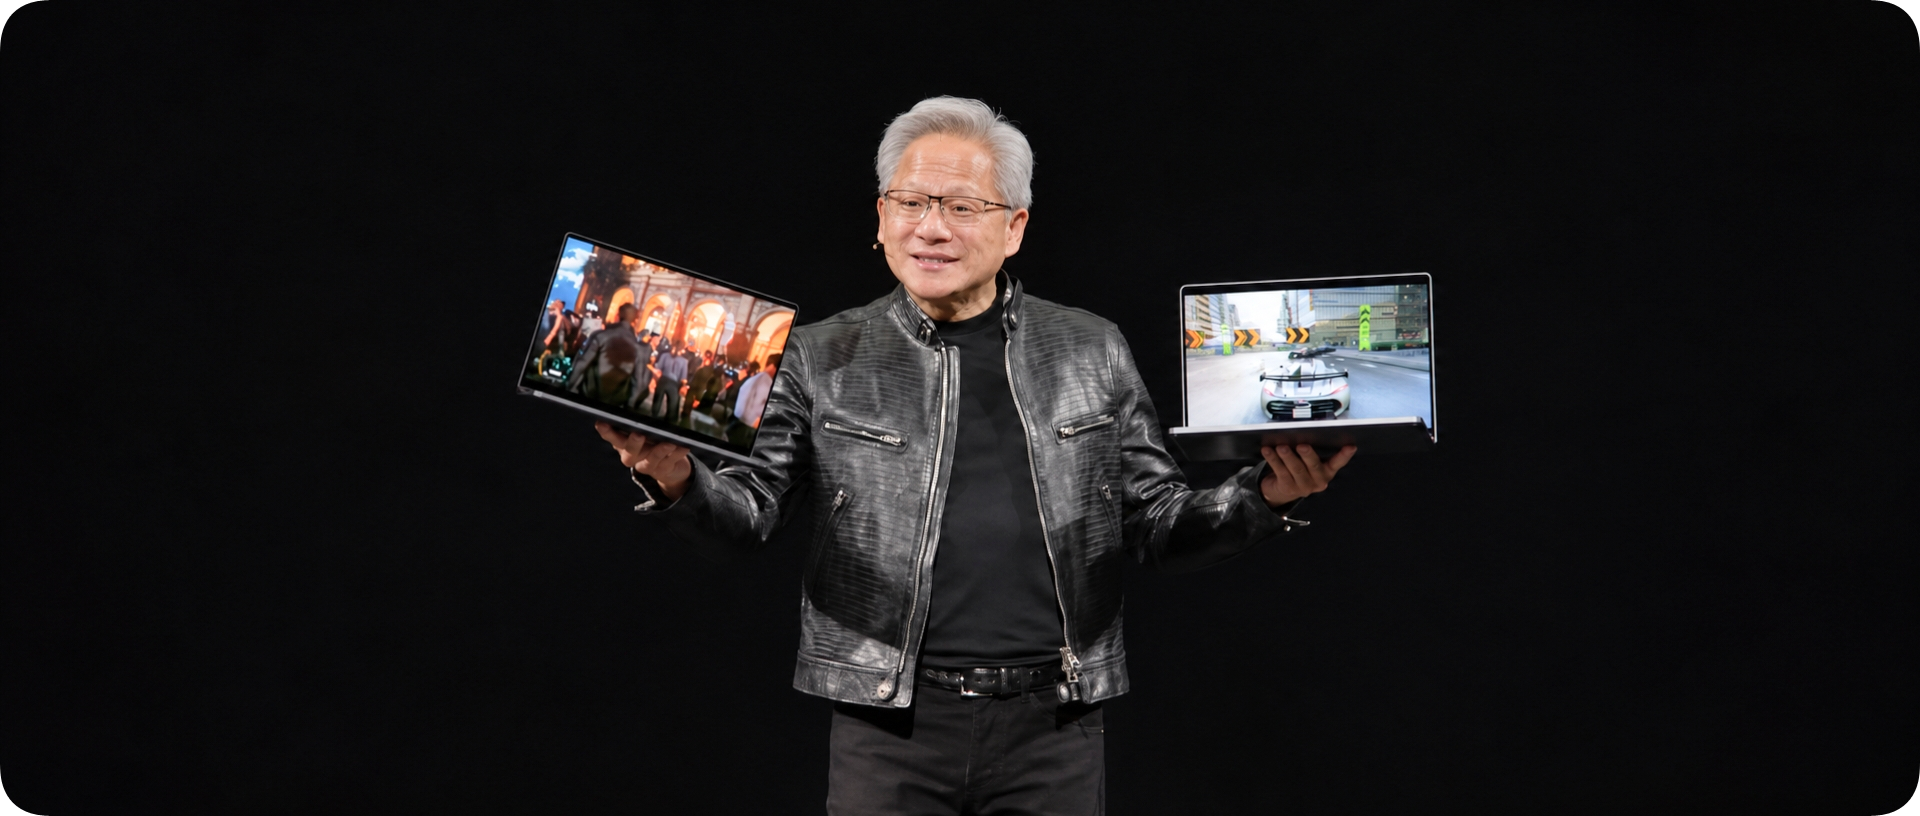 黄仁勋发布史上最强 Surface!专为「无限智能」设计
 HTX Ventures解读 CeFi、DeFi 与 TradFi 融合Reading the Room: Foundations, Design, and Challenges of Normative Competence in LLMsAgent Plasticity: Measuring Self-Improvement Through Experience
 从开源清理工具到付费 Mac 应用,用户教会了我如何做产品:MoleLearning to Report Unsafe Tasks in a Multi-Agent Game
 如何通过 DeFi 每天稳定产生 1000U 现金流?
 AICon 北京 2026 议题征集启动:寻找把 AI 做进真实生产的人Whose Memory Is It? Scope-Aware Commit Rules for Long-Term LLM Memory
 从 Rollout 到权重同步:Mooncake 如何支撑高性能强化学习系统|QCon上海定义了软件工程的计算机科学家 Margaret Hamilton 去世,享年 90 岁
 再裁员5000人!保时捷明确回归燃油车,高端车型计划涨价20%;腾讯拟发行50亿美元离岸债券,或筹钱加码AI;OpenAI全面上线GPT-6
 孙宇晨应战CZ健身之约:一年塑形请所有人监督法典终局锁档层|体系自洽与范式边界的闭环校验
 技术终将平权,做产品真正稀缺的是灵感与品味游戏公司最想要的社区,被小红书做成了“一座岛”浪子回头!Manus重启北京办公室大举招聘